
Server-side – kadonneen data-aarteen metsästäjät
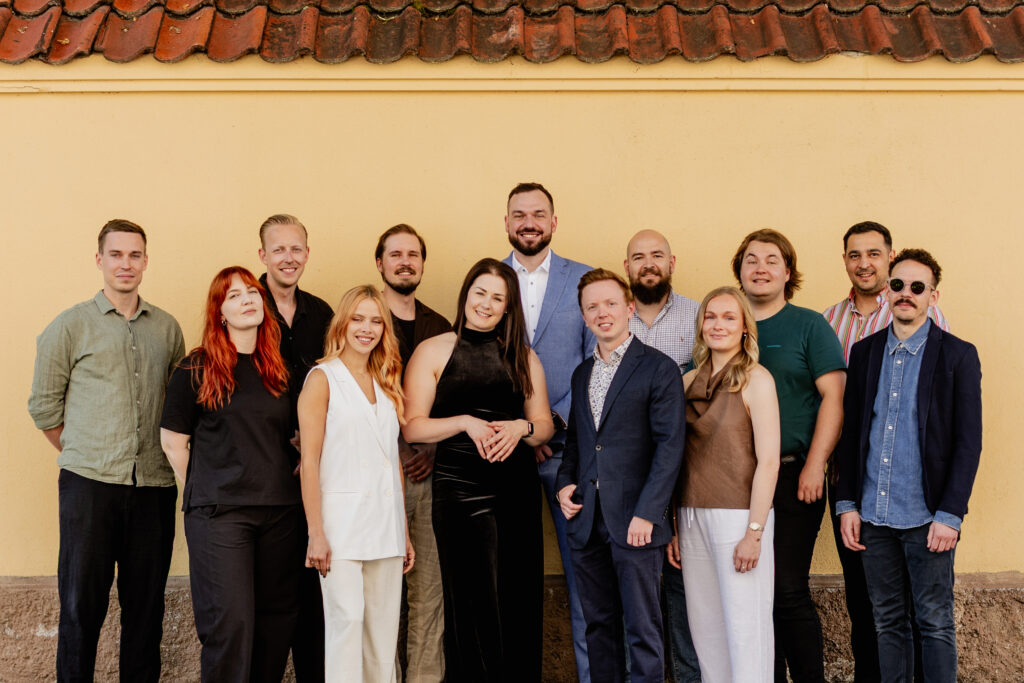
ASML kaappasi server side -tekemisen keskiöstä haastattelun Tracklutionin vetäjän Anni Salon (alla kuvassa keskellä ”tummissa”). Tracklution auttaa mainostajia saamaan maksetusta mainonnasta parempia tuloksia toimittamalla mainosalustojen algoritmeille laadukkaampaa dataa – ilman raskaita teknisiä projekteja tai jatkuvaa ylläpitoa. Annilla ja muilla perustajilla on vahva tausta tulospohjaisessa digimarkkinoinnissa, ja koko tuote syntyi alun perin ratkaisemaan omaa käytännön ongelmaa. Kun ratkaisu alkoi vähän pöydän alta levitä muidenkin käyttöön, se päätettiin tuotteistaa. Tracklutionia on rakennettu pari vuotta, ja se on käytössä jo tuhansilla verkkosivustoilla ympäri maailmaa.
1. Otetaan startiksi lyhyt server-side for dummies, mitä se on tänä päivänä?
Ennen kuin puhutaan server-side-seurannasta, pitää ymmärtää, miksi sitä ylipäätään tarvitaan.
Jos mietitään verkkosivuilta kerättävää (konversio)dataa, sen kerääminen on koko ajan vaikeampaa. Taustalla on sekä teknisiä muutoksia että tietosuojaan liittyviä vaatimuksia. Samaan aikaan Meta, Google ja muut mainosalustat ovat muuttuneet vahvasti algoritmivetoisiksi. Markkinoija ei enää säädä kaikkea käsin, vaan antaa alustalle tavoitteen, materiaalit ja jonkin verran reunaehtoja. Sen jälkeen algoritmi etsii asiakkaat.
Ja algoritmit oppivat vain yhdestä asiasta: datasta.
Konversioseuranta on käytännössä se oppimateriaali, jonka perusteella algoritmit oppivat tunnistamaan, millainen ihminen todennäköisesti ostaa juuri sinun tuotteesi tai palvelusi. Jos dataa puuttuu tai se on huonolaatuista, algoritmi oppii hitaammin ja tekee huonompia päätöksiä.
Palvelinpohjainen seuranta ei siis ole mikään itseisarvo. Ei yrityksiä kiinnosta, kulkeeko data selaimen vai palvelimen kautta. Yrityksiä kiinnostaa se, että mainonta toimii mahdollisimman hyvin ja että dataa voidaan käsitellä hallitusti myös tietosuojan näkökulmasta. Server side on tällä hetkellä paras tapa vastata molempiin haasteisiin.
2. Onko nopeasti muuttuvilla markkinoilla liikkeellä jotain vanhentuneita tai vääriä käsityksiä server-side -operoinnista?
On, ja yksi sitkeimmistä myyteistä on se, että server side poistaisi tarpeen eväste- tai suostumusbannereille. Ei poista. Suostumuksen tai muun käsittelyperusteen tarve ei riipu siitä, käsitelläänkö tietoa selaimessa vai palvelimella. Jos käsitellään eväste- tai henkilötietoja, siihen tarvitaan lainmukainen peruste. Oman juristin kanssa kannattaa tietenkin arvioida, mikä peruste missäkin tilanteessa on.
Se, mitä server side oikeasti muuttaa, on näkyvyys ja kontrolli. Selainpohjainen seuranta on monessa yrityksessä musta laatikko. Sivustolle on asennettu vuosien aikana tageja ja työkaluja, mutta kukaan ei välttämättä tiedä tarkasti, mitä ja mihin tietoa niillä lähtee eteenpäin. Palvelinpuolella jokainen datapiste voidaan nähdä ja siten kontrolloida: mitä kerätään, miten sitä käsitellään ja mitä luovutetaan kolmansille osapuolille. Samalla syntyy audit trail, jota selainpohjaisessa mallissa ei samalla tavalla jää yritykselle itselleen.
Tämä ei tee toteutuksesta automaattisesti sääntelyn mukaista, mutta se antaa yritykselle paljon paremmat työkalut sen varmistamiseen. Kun datavirta on näkyvä, sitä voidaan myös rajata. Turhat parametrit voidaan jättää pois, arkaluonteinen tieto siivota ja suostumukset huomioida ennen kuin mitään lähetetään eteenpäin.
Toinen vanhentunut käsitys on, että server side olisi aina valtava, kallis IT-projekti, joka kuuluu vain isoille yrityksille. Näin oli vielä joitakin vuosia sitten. Nyt on saatavilla palveluita, jotka hoitavat palvelinympäristön, integraatiot, rajapintapäivitykset, tietoturvan ja muut tekniset yksityiskohdat asiakkaan puolesta.
Muutos on vähän sama kuin CRM-järjestelmissä: joskus niitä rakennettiin itse, nykyään ne ostetaan lähes aina palveluna. Server side on menossa samaan suuntaan. Se ei enää automaattisesti tarkoita raskasta omaa kehitysprojektia.
3. Kuinka paljon isojen big tech -toimijoiden, kuten Metan ja Googlen, ehdot ja muutokset määrittävät server-side-arkkitehtuurin kehitystä?
Määrittävät aika paljonkin. Jos yritys käyttää rahaa Metassa, Googlessa tai muilla mainosalustoilla, se joutuu käytännössä toimimaan niiden pelisäännöillä. Mainonta on algoritmivetoista, joten kunnollinen konversioseuranta ja toimiva data feed eivät ole enää kiva lisä, vaan “must have”, jotta mainontaan käytettävä raha käytetään fiksusti.
Aiemmin kampanjasta löytyi enemmän vipuja, joista markkinoija pystyi itse säätämään kohdennusta ja optimointia. Nyt alustoille annetaan paljon enemmän päätösvaltaa. Silloin markkinoijan tärkeimmäksi ohjauskeinoksi jää se, millaista tietoa algoritmille palautetaan sen työn tuloksista.
Server side -arkkitehtuurin kannalta hankalaa on se, että jokaisella alustalla on omat järjestelmänsä. Metalla on omat rajapintansa ja datamallinsa, Googlella omansa, samoin TikTokilla, Snapchatilla ja muilla. Koska alustat kilpailevat keskenään, ne eivät rakenna mainostajalle yhtä yhteistä ja helppoa standardia.
Itse rakennettuna tämä näyttää aluksi helposti muutamalta rajapinnalta. Todellisuudessa kyse on infrastruktuurista, joka vaatii jatkuvaa ylläpitoa: rajapintaversiot vaihtuvat, kentät ja parametrit muuttuvat, ja välillä koko tapa toimittaa dataa menee uusiksi.
Tässä kohtaa palveluntarjoajan tehtävä on aika selkeä. Asiakas toimittaa datan yhteen paikkaan standardoidussa muodossa, ja me huolehdimme siitä, että se muutetaan jokaisen alustan vaatimaan muotoon, palvelimet skaalautuvat volyymin muuttuessa, ja että integraatiot pysyvät ajan tasalla. Markkinoijan ei pitäisi joutua käyttämään aikaansa Metan tai Googlen kenttämäppäysten seuraamiseen.
4. Online-analyytikan datavirtojen muutosjatkumo, hallinta, seuranta ja siihen liittyvä compliance-työ on melkoinen savotta, millaisena tämä maisema näyttäytyy teille?
Juuri sellaisena, eli savottana, ja usein vielä sekavampana kuin yrityksessä itse ymmärretään. Selainpohjaisessa seurannassa ongelmat jäävät helposti piiloon. Jokin työkalu lähettää dataa sivustolta eteenpäin, mutta kun virtaa ei nähdä, kukaan ei välttämättä pysähdy kysymään, mitä siellä oikeasti kulkee.
Kun seuranta siirretään palvelinpuolelle, datavirrat tulevat näkyviksi. Nykyään tekninen toteutus ei välttämättä olekaan enää vaikein osa. Organisaatio joutuu kohtaamaan kysymykset, joita se on voinut aiemmin vältellä: mitä tietoa keräämme, miksi keräämme sitä, miten sitä käsitellään, kenelle sitä lähetetään ja pitääkö jotain poistaa tai siivota matkan varrella.
Yllättävän moni yritys ja erityisesti moni markkinoija on näissä asioissa vielä aika kujalla. Ymmärrän sen hyvin, koska digitaalinen markkinointi ei ole enää vain markkinointia. Siinä pitäisi osata yhdistää markkinointiosaaminen, tekniikka ja tietosuoja. Harvalla ihmisellä on luontevasti kaikki nämä taidot.
Siksi tämä ei ole vain markkinointitiimin tai IT:n projekti. Mukaan tarvitaan yleensä myös tietosuojasta vastaavat ihmiset, ja jonkun täytyy omistaa kokonaisuus. Muuten jokainen tarkastelee vain omaa pientä osaansa eikä kukaan näe koko ketjua verkkosivulta mainosalustalle asti.
Kannustan silti markkinoijia käyttämään aikaa oman seurantasetupin ymmärtämiseen. Kun tietää, miten data liikkuu, myös tekniikka- sekä compliance-kysymykset ja mainonnan käyttäytyminen alkavat tuntua loogisemmilta. Kun kysyn usein puheenvuoroissani alkuun yleisöltä, kuinka monella on konversioseuranta käytössä, lähes kaikki kädet nousevat. Kun kysyn, kuinka moni tuntee oman toteutuksensa läpikotaisin, jäljelle jää hyvä jos edes kolmannes. Siinä on vielä aika iso osaamisvaje.
5. A-kysymys > Attribuutio-analytiikka ja affiliate-toiminta, mikä on server-siden rooli näissä?
Affiliate-markkinoinnissa seurantojen on pakko toimia, koska koko malli on tulospohjainen. Julkaisijan palkkio riippuu siitä, että konversio rekisteröityy oikein. Jos seuranta hukkaa osan kaupoista, julkaisija jää ilman hänelle kuuluvaa korvausta.
Tässä ei ole kyse vain raportoinnin epätarkkuudesta, vaan luottamuksesta ja puhtaasti rahasta. Affiliate-piirit ovat pienet, ja sana huonosti toimivasta seurannasta kiirii nopeasti. Hyvien julkaisijoiden on helppo siirtää huomionsa kilpailijalle, jonka seuranta toimii ja jonka kautta tehdystä työstä saa oikean korvauksen. Menetetyn luottamuksen palauttaminen on hidasta.
Pelkkä selainpohjainen seuranta ei nyky-ympäristössä pysty rekisteröimään kaikkea. Server side auttaa saamaan attribuutiosta luotettavampaa ja varmistamaan, että palkkiot perustuvat mahdollisimman kattavaan dataan. Jos affiliate on yritykselle oikeasti tärkeä kanava, palvelinpohjainen seuranta on pakko olla.
Mainostajan näkökulmasta huono seuranta vääristää myös päätöksentekoa. Jos osa myynnistä jää näkymättömiin, toimiva kumppani tai kanava voi näyttää todellista heikommalta. Silloin budjettia leikataan väärästä paikasta ja sama virhe kertautuu sekä kumppanisuhteessa että omassa analytiikassa.
Oman kokemukseni mukaan affiliate-markkinointiin kunnolla panostavat yritykset ovatkin keskimääräistä pidemmällä myös server siden käyttöönotossa yleisesti. Sama hyvä data palvelee samalla analytiikkaa ja maksetun mainonnan algoritmeja, joten hyöty ei jää vain yhteen kanavaan.
6. Miten AI on muuttanut ja muuttaa server-side-trackingia?
Ensimmäinen muutos on se, että AI tekee server-side-toteutuksista helpompia. Esimerkiksi julkaisimme hiljattain Tracklution MCP:n, jonka avulla käyttäjä voi asentaa verkkosivulle server-side-seurannan täysin keskustelemalla Clauden tai Cursorin kanssa. Aiemmin tekniseksi mielletty työ voidaan tehdä pitkälti promptaamalla.
Mun mielestä kiinnostavampi muutos liittyy kuitenkin siihen, miten dataa käytetään. Ihmiset eivät välttämättä tulevaisuudessa halua mennä erilliseen käyttöliittymään rakentamaan raporttia ja pyörittelemään dashboardia. He haluavat kysyä suoraan: mistä myynti tuli, miksi konversiot laskivat tai mitä kampanjaa pitäisi kasvattaa.
Raportit eivät kokonaan katoa, mutta niiden tekemisen tapa muuttuu. Sen sijaan, että jokaista uutta kysymystä varten rakennetaan pysyvä dashboard, AI voi muodostaa näkymän tarpeeseen ja antaa vastauksen siinä hetkessä. Tämä nostaa datan rakenteen paljon tärkeämmäksi kuin yksittäisen raportointityökalun.
Jotta AI pystyy vastaamaan järkevästi, datan täytyy olla sille luettavassa ja yhtenäisessä muodossa. Verkkosivun raakadata on sotkuista. AI:ta ei voi vain kytkeä sivustoon ja odottaa, että se ymmärtää automaattisesti, paljonko asiakkaita tuli ja mikä oikeasti tuotti kauppaa.
Väliin tarvitaan kerros, joka kerää, siivoaa ja yhdistää tiedot hallitusti. Käytännössä se tarkoittaa palvelinta ja server-side-infraa. AI voi tehdä käyttöönotosta ja analysoinnista paljon helpompaa, mutta se ei korjaa huonoa tai puuttuvaa dataa. Jos pohja ei ole kunnossa, vastauksetkaan eivät ole kunnossa.
7. Kokemukset LinkedInin aalloilta?
Tracklution ja erityisesti sinä itse olet ollut erityisen aktiivinen LinkedInissä. Teillä on reagointeja ajankohtaisiin muutostilanteisiin, karusellidokumentteja yms. Erityisesti olet hyödyntänyt videoita, joissa napakasti ja selkokielisesti avaat ja pohdit ajankohtaisia asioita. Kerro lopuksi kokemuksiasi LinkedIn:n tällaisesta hyödyntämisestä?
LinkedIn on mulle ennen kaikkea kiva tapa jakaa Tracklutionin arkea, ja siellä myös asiakkaamme ja muut sidosryhmämme pyörivät aktiivisesti. Samalla yritän tehdä tästä aika kuivasta, teknisestä ja compliance-painotteisesta aiheesta helpommin ymmärrettävää – rennosti, mutta asiallisesti. Yksi muistettavimmista hetkistä on ollut se, kun asiakas vastasi ”Mistä löysit meidät?” -kysymykseen: ”Annin meemeistä”. 😀 LinkedInistä tulee meille myös tasaisesti asiakkaita, joten kyse ei ole pelkästä näkyvyydestä. Joskus tuntuu hassulta, kun ihmiset tunnistavat mua tapahtumissa, ja vanhat tututkin saattavat nykyään tietää viimeisimmät kuulumiset jo ennen kuin ehdin kertoa niitä.